

지지율의 변화인가, 응답률의 변화인가
[서의곤의 여론조사 제대로 읽기] 같은 회사 여론조사도 엇갈리게 나오는 이유
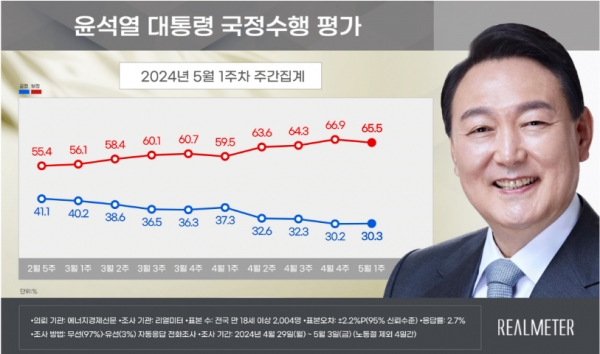
차기 대선이 60일도 안 남은 시점이지만 여전히 여론조사 결과는 혼란스럽다. 심지어 같은 날, 같은 여론조사 회사가 참여한 조사 결과가 서로 다르기도 하다.
전화조사는 사람이 전화를 해서 좀 더 답을 잘 해준다든지, 회사마다 특정 성향이 있다든지 하는 등 이유가 있다. 가끔은 ‘샤이 진보’니 ‘샤이 보수’니 하는 말도 한다. 즉 특정 성향 지지자들이 응답을 잘 안 해 준다는 것이다.
그런데 다 나름 충분한 가능성이 있는 이유들이지만, 우리가 관심갖는 것은 현재의 여론이지 여론조사 결과가 아니다. 여론을 알기 위해 여론조사를 하는데 여론조사 자체에 대해 많은 신경을 써야 한다면 문제가 있다.
응답률이 너무 낮다는 것은?
어쨌건 이렇게 결과에 영향을 줄 수 있는 여러 이유 중 응답률의 구조를 좀 더 자세히 살펴보고자 한다. 응답률이 너무 낮아서 조사 결과를 믿을 수 없다는 의견들도 언론의 기사나 인터넷 댓글 등에서 자주 볼 수 있기 때문에 이 부분을 좀 자세히 살펴보고자 한다.
표본조사란, 모집단 즉 현재 유권자 4300만명의 의견을 알고 싶은데 다 물어볼 수 없으니 그 중 1000명을 뽑아서 물어봤더니 이런 결과가 나왔더라, 라는 것인데 이 1000 명이 어떻게 구성되는지에 따라 조사가 정확할 수도 있고 그렇지 않을 수도 있다. 표본 조사는 우리가 관심갖는 문제 즉 후보별 지지율이 전체 모집단에서의 분포와 표본 1000 명의 분포가 비슷할 것으로 보기 때문에 가능하다. 이를 표본의 대표성이라고 하는데 모집단 4300만명의 지지율과 표본 1000명의 지지율이 비슷하면 대표성이 있는 것이다. 그런데 표본추출 절차에 따라 표본의 대표성에 문제가 생길 수 있다.
자세히 살펴보기 위해 아래 표를 보자. 아래 표의 데이터는 2022년 1월 11일 ~ 13일 사이에 갤럽에서 실시한 조사의 피조사자 접촉 현황 자료다. 이 자료는 중앙선거여론조사심의위윈회 홈페이지에 공개되어 있는 것을 인용했다.
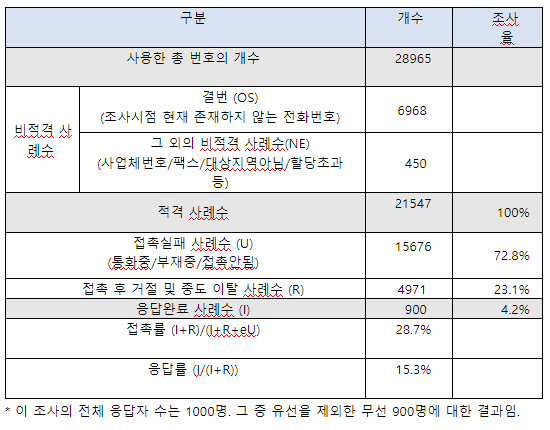
여러 숫자가 있지만, 맨 오른쪽 칼럼의 비율에서 100%라고 표시한 적격 사례수 대비 응답완료 사례수를 보자. 응답완료 비율은 4.2%인데, 우리가 결과적으로 보게 되는 후보별 지지율은 이 4.2% 즉 900명(전체 조사는 유선전화 면접 100명을 추가하여 1000명임)에서의 결과이다. 4.2%가 너무 낮다고 생각할 수도 있지만 통상 이 정도 응답률을 갖고 수집한 자료들이 상식에서 크게 벗어나지 않기 때문에 이런 조사 결과들이 의미가 있는 것이다.
900명의 비율을 언론에 공표할 때에는 표의 맨 아래 칸에 있듯 응답률 15%라고 발표를 한다. 그 내역은 그 계산 방식을 잘 살펴보면 알 수 있을 것이므로 따로 설명하지는 않겠다.
전화를 안받는 사람은 누구일까?
응답률과 관련해 우리가 관심가져야 할 부분은 접촉실패 사례수, 즉 U라고 표시된 부분이다. 조사회사는 모르는 사람에게 전화를 걸어 질문에 답을 해 주기를 부탁하는데, 전화를 아예 받지 않는 등 접촉 자체가 안되는 사람들이 대부분의 조사에서 70% 내외가 된다. 여론조사 결과에 대해 어떤 확정적인 결론을 내릴 수 없는 것이 이 집단에 대해 우리가 아무것도 모르기 때문이다. R로 표시된 거절 및 중도 이탈 사례가 있는데, 이 집단은 최소한의 정보는 얻을 수 있다. 목소리로 남자인지 여자인지, 그리고 대충의 연령대를 알 수 있고, 응답이 조금이라도 진행되면 지역 정도까지 알 수 있다. 그러나 70%를 차지하는 U 집단은 전혀 알 수가 없다.
조사의 응답률이 전체적으로 너무 낮아서 결과를 믿을 수 없다는 얘기가 많이 나오는데 응답률이 낮은 것 그 자체로 문제가 되는 것은 아니다. 문제는, 전체적으로는 5%가 응답을 하는데 후보별 지지군별로 응답률에서 차이가 나면 결과에 차이가 난다는데 있다.
내용을 쉽게 이해하기 위해 간단한 가정을 해 보자. 전체 유권자에 보수, 진보 지지자가 각각 동일하게 1500만명씩 있고 어느 쪽도 지지하지 않는다는 사람들이 1000만명 있어서 이들이 전체 모집단이라 가정하자. 즉 전체 모집단의 분포는 보수와 진보 지지율이 각각 37.5%, 그리고 유보층이 25.0%다.
조사를 위해 약 2만 명을 접촉을 하게 되는데, 전화번호는 랜덤 넘버이니 보수 및 진보 지지군이 각각 7500명 정도가 접촉이 되고 지지유보군이 5000명 접촉될 것이다. 여기까지는 어떤 편향을 일으키는 영향이 없을 것으로 추측된다.
샤이진보, 샤이보수가 존재할 여지는?
모든 지지군에서 응답률이 균질하게 5%라면, 보수 및 진보 지지자는 각각 375명 내외, 그리고 유보군은 250명이 조사에 포함될 것이다. 이것이 가장 이상적인 결과일 것이다. 그런데 이렇게 다른 외부적인 오류 요인 없이 진행이 되더라도 처음에 접촉하는 양 측의 지지자가 정확히 7500 명씩 되지 않을 수 있어서, 이상적인 숫자와 일치하지는 않을 것이다. 즉 오차가 생긴다. 그러나 약간의 변동이 있다 하더라도, 표본 숫자가 1000 명이라면, 이런 조사를 스무 번 했을 때 열아홉 번은 보수나 진보 어느 한 지지율이 34.5%에서 40.5%의 범위를 벗어나지 않으리라는 것이고, 이것이 통상적으로 언론에서 95%오차 범위라고 말하는 것이다.
오차범위란 이렇게 표본추출, 즉 샘플링 자체는 이상적으로 진행된 상황에서의 오차를 계산한 것인데, 샘플링 외의 영향 요인들이 너무나 많다. 응답률이 대표적인데, 만약 보수 지지군과 진보 지지군 간에 응답률에서 차이가 있으면 전체 결과가 모집단의 분포에서 벗어난다. 예를 들어 보수 지지군의 응답률이 6%이고 진보 지지군의 응답률이 4%, 그리고 유보층이 5%라면, 보수군은 접촉된 7500명 중 450명이 조사에 참여하고 진보군은 7500명 중 300명, 그리고 유보층은 접촉된 5000명 중 250명이 조사에 참여할 것이다.
여기서 조사에 참여한다고 적극적인 표현을 썼지만 이 사람들이 최종 조사 표본 1000명에 포함된다는 뜻이다. 결과적으로 유보층 25%는 변함이 없는 반면 보수와 진보 지지율은 45% 대 30%의 결과가 나와버린다.
이런 오류들을 non-sampling error라고 하는데, 이런 non-sampling error가 작용하면 그 이후의 데이터를 설명하기가 매우 어려워진다. 지금 예로 든 것처럼 지지군 간에 응답률이 다르다고 하면, 이걸 측정할 방법이 없다. 그래서 ‘샤이진보’, ‘샤이보수’ 등의 말이 나오고 실제 생각과 다른 답을 하는 등을 원인으로 추측하는데 그 정도가 어느 정도인지 알 수가 없고 오차 등을 계산할 수가 없다.
지지율이 변한 걸까, 응답률이 변한 걸까
이러다 보니 조사에서 나오는 지지율의 변화가 실제 지지의 움직임을 반영한 것이 아니라 단지 지지자들 간 응답률의 변화에 의한 것일 수 있다. 예컨대 윤석렬 후보와 이준석 대표의 화해 등으로 인해 야권 지지율이 올라갔다고 하는데, 이것이 실제 지지율의 움직임이 있어서가 아니라 야권 지지자들이 여론조사에 더 많이 응답을 해서 달라진 결과일 가능성을 배제할 수 없다. 또한 오차 범위를 공표하는데 sampling 이론을 정확히 모르는 사람이라면 마치 non-sampling error를 포함한 오차범위라 생각할 수도 있다.
현실에서, 어떤 한두 가지 요인 때문에 이런 극적인 차이가 나는 경우가 흔하지는 않다. 가장 쉽게 생각할 수 있는 지지율 자체의 변화를 먼저 고려해야 한다. 그러나 지금까지 선거조사와 실제 선거 결과에서 큰 차이가 난 경우가 몇 번 있었고 non-sampling error를 조사회사들이 사실상 인정하고 있는 만큼 여러 가능성을 면밀히 검토해야 한다.
전향적인 방법을 찾아야
이런 문제를 해결하려면 표본추출과정에서 얻어지는 데이터를 좀 더 잘 분석해볼 필요가 있다. 앞의 표에서 U 및 R에 해당하는 사람들의 분석이다. 물론 이 집단은 데이터가 없기 때문에 어떤 사람들인지 해석이 쉽지 않겠지만, 최대한 관련 자료를 수집해 최종 결과를 보완하려는 노력이 필요하다.
또 조사 결과 분석에 포함시키는 응답자를 질문의 끝까지 응답한 사람만 포함시키는데 이것도 재고할 필요가 있다. 조사 과정에서 중간 정도까지 응답하다가 중단한 사람들의 데이터는 모두 버려지는데, 가장 민감한 지표 한두 개 외에는 엄밀한 대표성이 필요한 건 아니다. 예컨대 지지후보를 바꿀 생각이 있느냐? 등의 질문은 각 후보 지지자 내에서의 비율이 중요하므로 전체 조사표본까지 대표성을 가질 필요는 없다고 생각한다.
무엇보다 여론조사 원칙을 중앙선거여론조사심의위원회에서 정해 두었는데, 표본추출 방법, 가중치 부여 방법, 표본수 등을 정해 둔 것이다. 그런데 현재 이 규정을 따라서 하고 있는데도 조사들 간에 결과에서 차이가 많이 나는 만큼 별 의미가 없다고 본다. 조사회사 독자적으로 자체 예측 모델을 구축하여 그 결과를 공표하는 것이 차라리 낫다고 생각된다.
서의곤 BRiO 대표
사람을 이해하는 기업 BRiO의 서의곤 대표는 서울대 심리학 석사, 영국 맨체스터 비지니스 석사(MBA)로 국내, 글로벌 조사회사에서 근무했다. 소비재 패널 조사방식을 국내체 첫 도입했고, 1996년 15대총선 당시 국내 최초로 선거 결과조사에 참여했다. 한국환경정책평가연구원 등 공공기관 조사프로젝트를 수행했다.
댓글