

시스템반도체 산업의 미래를 전망하다
[김정민의 친절한 IT이야기] ‘엔비디아 시대’ 종언 가능성은? 오픈소스인 RISC-V 아키텍처 덕에 다가오는 ‘맞춤형 AI칩 설계’ 시대 엔비디아 강점 없고, 새 강자 출현 가능
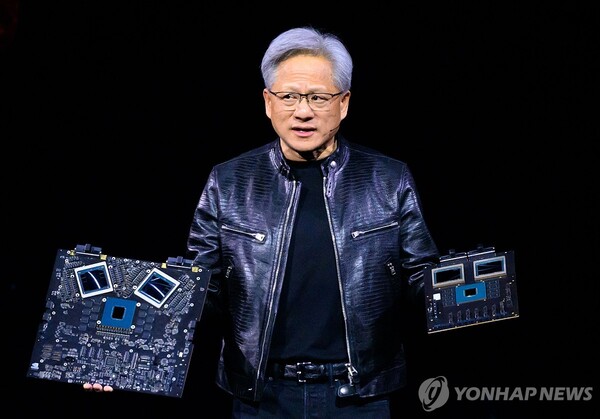
지난 3월18일에 ‘엔비디아 GTC(GPU Technology Conference) 2024’가 열렸다. 여기서 젠슨 황 엔비디아CEO는 2시간 동안 기조연설을 하며 차세대 AI칩 ‘B200’을 선보였다. 이후 GTC 2024에 관해 놀라움과 찬사가 이어졌지만, 사실 별로 놀랄 것도 주목할 이유도 없는 발표라고 생각하는 소수의 사람들도 있다. 누군가는 GTC 2024에 놀라움과 찬사를 보냈으며, 반대로 몇몇 사람들은 엔비디아 시대가 곧 끝날 것이라고 생각한다. 그 이유는 무엇일까. 최신 AI 산업과 GPU를 비롯한 시스템반도체 산업의 분석을 통해 누구의 생각이 맞는지 알아보자.
컴퓨터의 구조(Architecture)와 AI
‘혁신’이라는 키워드를 10년 이상 독점해 왔던 애플을 뒤로하고, 엔비디아가 그 바통을 이어받아 회사의 규모도, 밸류도 급격히 상승하고 있다. 챗GPT를 내세운 오픈AI는 AI 서비스 분야를 독점하고 있고, AI와 딥러닝 애플리케이션에 최적화된 고성능 GPU를 생산하는 엔비디아는 AI 하드웨어 분야를 독점하고 있다.
그런데, 엔비디아가 잘한다는 GPU(Graphics Processing Unit)는 무엇인가? 이 부분은 슈퍼컴퓨터에 관한 칼럼(슈퍼컴퓨터란 녀석, 인류를 구할 수 있을까)에서 비교적 자세하게 설명했으니, 여기서는 핵심만 짚고 넘어가자.
컴퓨터는 하드웨어와 소프트웨어로 나뉘고, 하드웨어 즉 컴퓨터 구조에서 가장 중요한 부품은 중앙처리장치인 CPU이다. CPU는 모든 일을 골고루 잘 처리하는 프로세서인 반면, AI 시대에 각광 받는 GPU는 특정한 단순 반복적인 일만 매우 빠르게 처리하는 프로세서이다. 따라서 CPU 제작은 복잡하고 어려울 것이고, 상대적으로 GPU 제작은 간단하고 쉬울 것 같은데, 어떻게 엔비디아가 GPU 시장을 독점하고 있을까?
핵심은 대량의 연산을 얼마나 빠르게 하느냐이다. 젠슨황이 이번 기조연설에서 ‘가속 컴퓨팅’이라는 단어를 많이 사용했는데, ‘빠른’ 연산을 의미한다. 예를 들어 커다란 주머니에 1만장의 숫자 카드가 들어있고, 카드에 적힌 숫자를 모두 더해야 하는 작업이 있다고 가정해보자. 첫번째 숫자부터 마지막 숫자까지 혼자서 순차적으로 더하면 총 9999번의 덧셈을 해야 한다. 이 숫자 카드를 10명이 1천 장씩 나누어서 동시에 계산하면 연산 시간은 1/10로 줄어들 것이다. 100명이 100 장씩 나누어서 하면 연산 시간은 1/100으로 줄어들 것이다. 다만 여기에는 100명이 더한 결과를 다시 모아서 더하는 작업이 필요하다. 100명의 덧셈 속도가 조금씩 다르다면, 제일 느린 사람이 덧셈을 마칠 때까지 기다린 다음 모아서 하는 덧셈을 시작할 수 있다.
여기서 중요한 개념이 3가지가 나온다. 즉, ‘작업을 나누는 것(작업자의 덧셈 역량 파악이 전제)’, ‘작업자간 소통(덧셈을 마쳤는지 확인)’, 그리고 ‘결과를 합치는 것’이 그것이다(다음부터 이 세가지를 합쳐 ‘나소합’이라 부르겠다). 단순 반복적인 일을 빠르게 하려면, 작업자의 능력에 맞게 일을 잘 나누어야 하고, 작업을 동시에 마칠 수 있도록 감시하여야 하며, 다시 합치는 일의 속도도 중요하다. 젠슨 황이 강조하는 가속 컴퓨팅의 핵심은 “나누고 소통하고 합치는 것”을 얼마나 빨리하느냐이다. 수많은 GPU들에 일을 나눠주고 소통하고, 결과를 합치는 일을 누가 빨리하는지가 핵심이다.
젠슨 황은 이번 GTC에서 ‘블랙웰(B200)’ GPU를 공개했다. 이후 B200 여러 개를 연결해서 ‘GB200’을 만들고, GB200 36개를 조합해 ‘DGX GB200’을 만드는 과정, DGX GB200을 모아서 DGX 슈퍼팟을 만드는 과정을 키노트를 통해서 보여줬다. GPU의 개수가 늘어날수록 동시에 처리하는 작업량은 늘어나지만, ‘나소합’ 속도의 중요성도 점점 커진다.
챗GPT는 대규모 데이터를 학습하기 위해 1만개가 넘는 GPU를 사용하고 있는 것으로 알려져 있는데, ‘나소합’의 속도가 성능 전체를 좌우할 수 있다. 이 중 소통하고 합치는 일은 메모리에 기록하고 다시 이를 불러와서 연산하는 작업인데, HBM(High Bandwidth Memory)은 이런 작업 때문에 매우 중요해졌다. High Bandwidth라는 것은 많은 정보를 동시에 빠르게 쓰고 읽을 수 있다는 것을 의미한다.
엔비디아의 독점은 언제까지 지속될 것인가
엔비디아의 독점은 빠른 속도를 자랑하는 GPU와 ‘CUDA’라는 엔비디아 GPU 위에서 동작하는 SDK 덕분에 가능했다. SDK(Software Development Kit)는 개발자가 사용하는 소프트웨어 개발 툴인데, 간단하게 개발자가 설계한 AI모델을 GPU(주로 GPU 집합)가 이해하는 기계어로 지시하고, 최적화된 ‘나소합’을 지시하는 소프트웨어라고 생각하면 된다. CUDA는 GPU에서 딥러닝을 수행하기에 최적화된 툴인데, 엔비디아 GPU 위에서만 돌아간다. 2006년부터 제공된 이 툴을 많은 개발자들이 사용하여 엔비디아의 생태계를 만들었는데, 당시에는 CUDA와 같은 툴이 몇 개 없었다. 이후 딥러닝이 각광을 받게 되자 CUDA에 락인된 개발자들은 계속해서 CUDA를 사용하게 되었다.
딥러닝 개발자들은 CUDA라는 툴킷을 이용하여 프로그램을 개발하고, 이 프로그램은 엔비디아의 GPU에서 최적화되어 돌아간다. 엔비디아도 최신의 딥런닝 연산을 할 수 있도록 CUDA를 지속적으로 업데이트하고 있다. 마치 아이폰 전용앱을 사용하기 위해 애플 스마트폰을 사용하는 것과 비슷하다.
그런데 최근 시장이 빠르게 변화하고 있다. AMD, 인텔, 그리고 새로운 팹리스(반도체 설계 회사) 경쟁자들이 등장함에 따라 엔비디아의 지위가 도전받고 있다. 엔비디아보다 성능이 좋은 GPU를 만들고, CUDA보다 성능이 좋은 툴킷을 개발하고 있다. AMD도, 인텔도 자사의 AI 전용 칩과 툴킷을 개발하고 있다. 반면, 엔비디아의 GPU는 가성비가 점점 떨어지고 있다. 성능은 같은데 가격이 비싸져서 그렇다. GPU의 공급 부족으로 가격이 올라 가성비가 매우 떨어진 상황인데, 개발자들이 엔비디아를 꼭 써야한다면 독점이 유지될 수 있겠지만, 현재는 대체제가 많이 생겨나고 있다.
엔비디아는 현재 GPU 시장의 80~90%를 장악하고 있지만, 앞으로 점유율이 계속해서 낮아질 것이고, 젠슨 황도 여러 인터뷰에서 이런 미래를 잘 알고 있다고 얘기한다.
AI 칩의 미래...탈 엔비디아 성공의 열쇠는 아키텍처
과연 경쟁사들이 엔비디아보다 뛰어난 성능의 GPU를 제조할 수 있고, CUDA보다 유용하고 빠른 툴킷을 제공할 수 있을 것을까.
경쟁사가 만드는 새로운 AI칩은 아키텍처가 중요하다. 반도체 칩을 설계하는 구조를 아키텍처라고 하는데, 인텔은 x86 아키텍쳐를, ARM은 암(ARM) 아키텍처를 사용하고, 둘 다 특허가 걸려있어 다른 회사가 이를 사용하려면 거액의 로열티를 내야 한다. 반면 최근 주목받는 RISC-V(리스크파이브) 아키텍처는 오픈소스이다. 마음대로 수정할 수 있고, 맞춤형으로 제작할 수 있다. 실제로 RISC-V 진영은 최근 8년만에 160배나 성장했고 연평균 33% 성장하고 있으며, 인텔도 여기에 참여하고 있다.
한편, ‘뛰어난 성능’이라는 개념도 점점 일반화가 어려워지고 있다. 글로벌 AI회사는 자신만의 AI칩 제작을 위해 자체설계를 하고자 한다. 자신들의 딥러닝 모델에 맞는 학습과 추론을 할 수 있는 맞춤형 반도체 칩을 원하는 것이다. 여기에 RISC-V가 해답을 제시하고 있다. 테슬라도 차량에 탑재되는 AI칩을 자체 설계한다. 시속 100㎞로 자율주행하는 차량에서 0.1초만에 판단하는 것과 0.05초만에 판단하는 것은 매우 큰 차이다. 자율주행에만 특화된 AI칩이 반드시 필요한 이유다.
삼성전자는 최근 미국 실리콘밸리에서 AI 반도체 설계를 위한 연구개발(R&D) 조직을 더 키우겠다고 발표했다. RISC-V 아키텍처로 엔비디아의 아성을 무너뜨릴 차별화한 반도체를 만들겠다는 야심을 표현한 것으로 보인다. 지금까지 삼성은 엔비디아를 넘기 위해 ARM아키텍처를 사서 써왔는데, RISC-V를 기반으로 ‘기술 독립’을 추진하는 것으로 풀이된다. 최근 테슬라는 차셰대 AI칩 생산을 TSMC가 아닌 삼성전자 파운드리에 맡기기로 하면서, AI 칩을 둘러싼 전쟁은 더욱 치열해질 것으로 보인다.
자체 AI칩 개발의 필요성은 AI 서비스의 개발 과정을 통해 확인할 수 있다. 과정을 보면 ①딥러닝 모델을 설계하고, ②학습용 데이터로 딥러닝 학습을 시킨다. ③학습이 완료되면 테스트용 데이터로 테스트를 해 모델을 평가하고 합격점을 받으면 모델을 ④상용화해 일반 데이터에 대해서 서비스를 하게 된다. 엔비디아는 보편화된 딥러닝 모델에 맞춰 GPU를 설계하였고, 많은 개발자들의 선택을 받았다.
그러나 현재는 보편화된 딥러닝 모델이 아니라, 인공신경망을 비롯하여 개별적인 딥러닝 모델이 등장하고 있고, 이에 맞는 맞춤형 AI 칩의 수요가 늘어가고 있다. 주식거래에 특화된, 자율주행에 특화된, 언어생성에 특화된 딥러닝 모델이 따로 있고, 이것만을 잘하는 AI칩을 설계할 수 있다. 엔비디아는 CPU라는 범용 프로세서로부터 차별화해 그래픽처리에 특화된 GPU라는 비(非)범용 프로세서로 승승장구했다. 하지만 현재는 옛날 CPU 진영이 그랬던 것처럼 엔비디아 GPU는 다목적이고 구닥다리가 되었고, 맞춤형 GPU 진영의 도전을 맞닥뜨리고 있다.
시장의 반응도 매우 빠르다. AI모델과 앱들은 안정적인 고객 서비스를 위해 클라우드에서 돌아간다. MS는 탈 엔비디아를 조용히 준비하고 있고, 구글도 TPU라는 프로세서를 만들어서 엔비디아 GPU를 쓰지 않겠다고 선언했다. 오픈AI의 샘 알트만 CEO도 엔비디아로부터의 독립에 앞장을 서고 있다.
하지만 지금까지는 독립의 여정이 녹녹지 않다. 구글은 자사 클라우드 서비스에 자사 TPU를 이용하려고 노력함에도 여전히 엔비디아 GPU의 이용률이 80%이상이다. 개발자들이 CUDA와 엔비디아 GPU에 락인되었기 때문이다. 하지만 개발자들에게 다양한 GPU와 다양한 툴킷의 옵션을 제공하는 클라우드가 늘어나고 있다.
클라우드 서비스중 엔비디아 GPU의 비중이 70%로 가장 낮은 서비스는 아마존의 AWS인데, 이는 AWS가 자체 AI칩을 탑재하고 뼈를 깎는 노력을 한 결과로 보인다. CUDA 위에서 돌아가는 딥러닝 모델과 프로그램이 AWS의 AI칩에서 돌아가려면 프로그램을 대폭 수정을 해야하는 수고가 들어가지만, 서버 비용을 엔비디아 GPU에 비해서 1/4정도로 줄여서 개발자의 마음을 사고 있다. 고객들에게 AI서비스를 지속적으로 해야하는 기업 입장에서 운영비용이 1/4이라는 것은 엄청난 메리트이다. AWS가 실제 비용을 낮췄는지, 제 살 깎는 덤핑을 하고 있는 것은 모를 일이다.
이렇게 되니, 엔비디아는 대응책으로 자체 클라우드 서비스를 내놓았고, 맞춤형 AI 시장 공략을 시작했다. 엔비디아는 아마존, 메타, 구글, 오픈AI 등과 만나 이들 개별 기업을 위한 맞춤형 칩 제작에 대해 논의한 것으로 알려졌다. 데이터 센터용 칩 외에도 통신, 자동차, 비디오 게임 고객을 위한 칩설계도 시작했다.
맞춤형 AI칩, 누가 승자가 될 것인가
맞춤형 AI칩 설계는 엔비디아가 강점이 있는 분야가 아니다. 각 분야의 터줏대감이 있다. 통신, 자동차, 주식금융, 데이터 센터용 칩에 각 분야의 강자가 따로 있다. 맞춤형 AI칩에서는 CUDA라는 툴킷은 무용지물이다.
최근에는 인공신경망 연산에 최적화 되어 있는 NPU(Neural Network Processing Unit)도 속속 등장하고 있다. 온디바이스 AI 관련이 있기는 하지만 GPU에서 NPU로의 변화는 모두가 주목하는 큰 흐름이다. NPU는 고유한 아키텍처를 가지고 있는데, 특수 연산 유닛, 대용량 메모리 대역폭, 효율적인 데이터 흐름 관리가 기본이다.
삼성전자, 퀄컴, 인텔 등 반도체 회사들은 이미 NPU를 미래 먹거리로 생각하고 시장 확대에 사활을 걸고 있다. 최근엔 애플, 구글, 아마존 등 글로벌 테크기업과 LG전자까지 NPU 개발 행렬에 동참했다. 다른 회사가 만든 NPU를 사서 쓰는 것보다 맞춤형 NPU를 직접 개발해야 온디바이스 AI 제품을 제대로 구동할 수 있고, 맞춤형 AI 학습과 추론이 가능하기 때문이다. 여러 회사가 자체 맞춤형 칩 설계를 꿈꿀 수 있는 이유는 오픈소스인 RISC-V(리스크파이브) 아키텍처 덕분이다.
결국, 맞춤형 AI칩 설계는 엔비디아도 기득권이 딱히 없는 제로베이스 영역이고, 곧 춘추전국시대가 펼쳐질 것으로 보인다. 각 분야별 터줏대감이 처음에는 강점을 보일 수 있지만, 반도체 설계는 경험과 천재의 능력이 반반 필요한 분야라 확보한 인재에 따라서 언제든지 기술력은 뒤집힐 수 있다. 그리고 제작은 TSMC와 삼성전자 파운드리가 있으니 믿고 맡기면 그만이다.
김정민 변호사
김정민 변호사 겸 (주)위츠 대표이사는 서울대에서 컴퓨터공학, 법학(부전공)을 공부했다. 4회 변호사시험에 합격 후 IT기업 준법팀장을 거쳐 법무법인 경세 파트너변호사, 대한변호사협회 IT블록체인특위 간사, (사)한중법학회 이사, 한국NFT학회 이사, 한국블록체인사업협동조합 자문변호사로 일하고 있으며, 라이선스 간편거래 플랫폼 위츠의 대표를 맡고 있다.
댓글